9월 중순부터 개발자 유튜버마다 JEV 이야기를 한다. 처음에는 챗지피티 같은 LLM이 또 하나 나왔나 했는데 읽어 보니 종류가 아예 달랐다. 이 모델은 글을 쓰지 않는다. 문장을 한 줄도 만들지 않는다.
AI를 공부하기 시작하면 ‘AI = 챗봇’으로 굳어지기 쉽다. 나도 그랬다. JEV는 그 등식이 깨지는 자리라서, 공부 삼아 정리해 뒀다. 아직 나온 지 일주일 남짓이라 모르는 것도 많은데, 모르는 건 모르는 대로 적었다.
JEV가 뭔가
샌프란시스코의 TypeSafe AI가 만들었다고 한다. 2024년에 생긴 회사다. 2026년 9월 15일에 신청한 사람에게만 먼저 열어 주는 방식으로 공개했고, 같은 날 4천만 달러 투자를 받았다고 발표했다. 그때 매겨진 회사 값어치가 2억 달러다.
대표 Diogo Almeida는 OpenAI에서 4년을 일했다. 챗지피티를 만든 팀에 있던 사람이다.
회사는 JEV를 ‘System One 모델’이라고 부른다. 심리학에서 빌려 온 이름으로 보인다. 곰곰이 따져서 답하는 쪽이 아니라 보자마자 판단하는 쪽을 가리킨다. 사람으로 치면 할 말을 고르는 게 아니라 그냥 안다고 할 때의 그 감각이다.
문장을 안 만든다
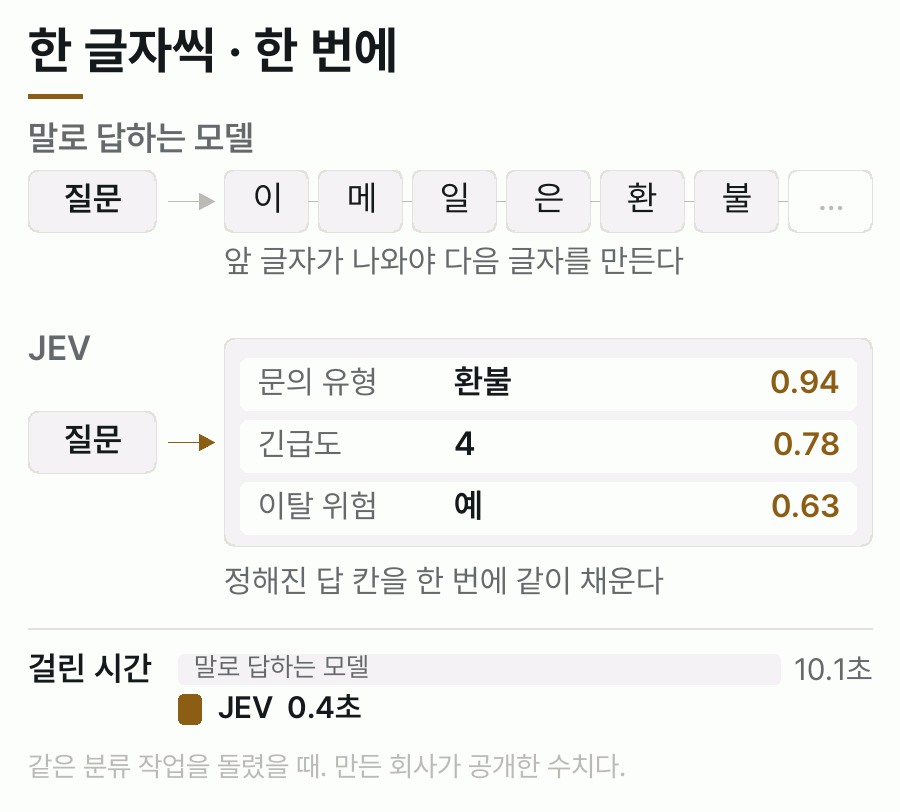
LLM은 다음에 올 글자를 맞히는 훈련을 받은 모델이다. 그래서 답이 늘 사람이 읽을 문장으로 나온다. 이게 채팅에는 더없이 잘 맞는데, 프로그램이 알아서 일을 처리하게 만들려면 영 불편하다.
소프트웨어가 LLM을 쓸 때 벌어지는 일을 떠올려 보면 된다. “JSON이라는 정해진 형식으로만 답해 줘”라고 부탁한다. 그래도 앞뒤에 인사말이 붙어 나오니 떼어 낸다. 프로그램이 그걸 읽다가 형식이 어긋나면 처음부터 다시 부른다. 없는 항목을 지어내지 않았는지도 검사해야 한다. 판단 하나 받자고 문장을 만들게 한 다음 그 문장을 도로 해체하는 셈이다.
Almeida는 이 상황을 두고 번개를 병에 담아 뒀는데 정작 쓸모가 없다고 말했다. LLM이 사람의 언어에 맞춰 최적화된 물건이라 기계가 쓰기엔 낭비라는 뜻인 것 같다.
JEV는 그 중간 단계를 통째로 없앴다. 앱의 상태와 질문을 넣으면 값과 확률이 그대로 돌아오고, 문장은 처음부터 끼어들지 않는다.
한 글자씩 쓰지 않는다
여기서 속도 차이가 난다. LLM이 느린 이유는 모델이 무거워서만이 아니라 앞 글자가 나와야 다음 글자를 만들 수 있기 때문이다. 이런 방식을 자기회귀라고 부른다. 자기가 방금 쓴 걸 다시 보고 그다음을 쓴다는 뜻이다. 100글자짜리 답이면 100번을 순서대로 돈다.
JEV는 답이 들어갈 칸이 미리 정해져 있어서 순서를 기다릴 이유가 없고, 질문이 몇 개든 한 번에 같이 평가한다고 한다. 회사가 밝힌 응답 시간은 70밀리초에서 500밀리초 사이다.
다만 회사가 설계도 학습 결과물도 논문도 내놓지 않아서, 안에서 실제로 무슨 일이 벌어지는지는 밖에서 확인할 방법이 없다. 아래 내용도 대부분 회사가 한 말을 옮긴 것이다.
주고받는 모양
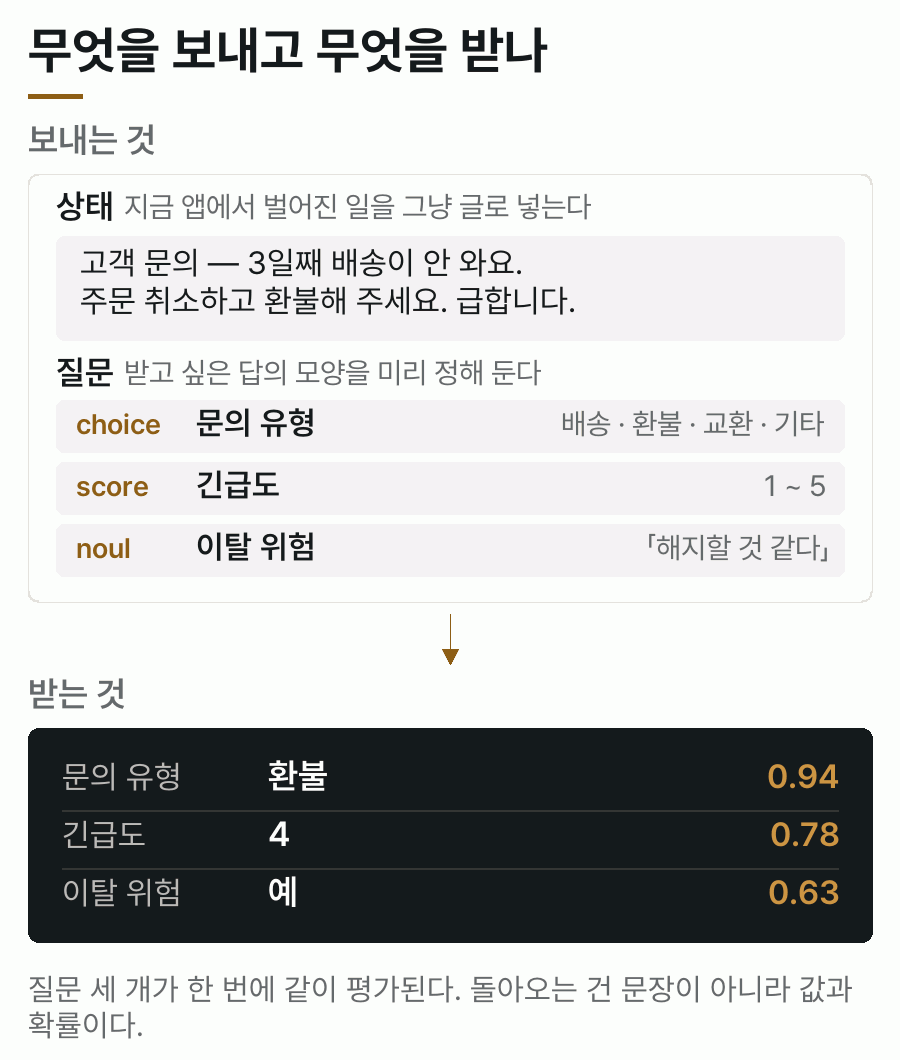
실제로 뭘 보내는지를 보면 감이 빨리 온다. 요청은 두 덩어리다. 하나는 ‘상태’고 하나는 ‘질문’이다.
상태는 형식이 자유롭다. 지금 앱에서 벌어진 일을 글로 넣으면 되고, 고객이 남긴 문의 원문이든 주문 내역을 쭉 적은 목록이든 상관하지 않는다.
질문은 반대로 아주 빡빡하다. 어떤 종류의 답을 받을지, 보기가 뭔지를 미리 못 박는다. 이게 이 모델의 핵심인 것 같다. 답의 모양을 내가 정해서 보낸다.
답의 모양 세 가지
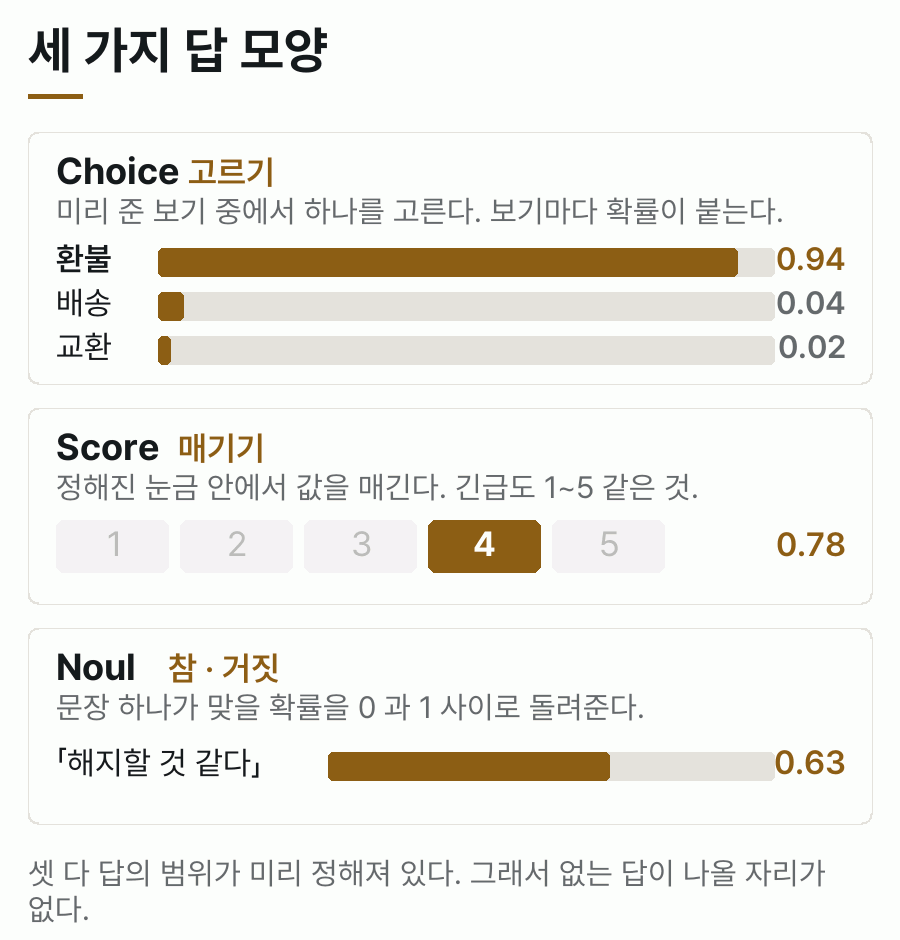
받을 수 있는 답은 세 종류뿐이다.
choice는 준 보기 중에서 하나를 고르고 보기마다 확률을 따로 붙인다. score는 긴급도 1에서 5처럼 정해진 눈금 안에서 값을 매긴다. noul은 문장 하나가 참일 확률을 0과 1 사이 숫자로 돌려주는데, 이 이름은 회사가 지어낸 말로 보인다.
세 가지가 전부라는 게 답답해 보이는데, 실무에서 소프트웨어가 AI에 시키는 일을 떠올려 보면 의외로 이 안에 다 들어간다. 분류하고, 점수 매기고, 참인지 보는 일.
확률이 진짜 확률이다
나는 이 대목이 제일 재미있었다.
LLM에게 “몇 퍼센트 확신하냐”고 물으면 숫자를 준다. 그런데 그 숫자는 확률이 아니라 확률처럼 생긴 글자다. 95%라고 답한 것들만 모아 보면 실제로는 70%쯤 맞는 식으로 어긋난다. 모델이 자기 확신을 재서 말하는 게 아니라, 그 자리에 올 법한 말을 고른 것이기 때문이다.
JEV는 여기를 정면으로 겨눴다. 배우는 방식부터 다르다.
LLM은 보통 사람이 어느 답을 더 마음에 들어 하는지를 보고 다듬는다. 이걸 RLHF라고 부른다. JEV는 다른 걸 봤다. 말한 확률이 실제 결과와 얼마나 맞아떨어지는지로 점수를 매겼다고 한다. 회사는 이 방식을 RLCD라고 부른다. 말한 확률과 실제가 들어맞는 것을 보정이라고 하는데, 그 보정을 학습 목표로 삼았다는 뜻이다.
학습에 쓴 자료도 사람이 모은 게 아니라 전부 기계로 만들어 낸 것이라고 한다.
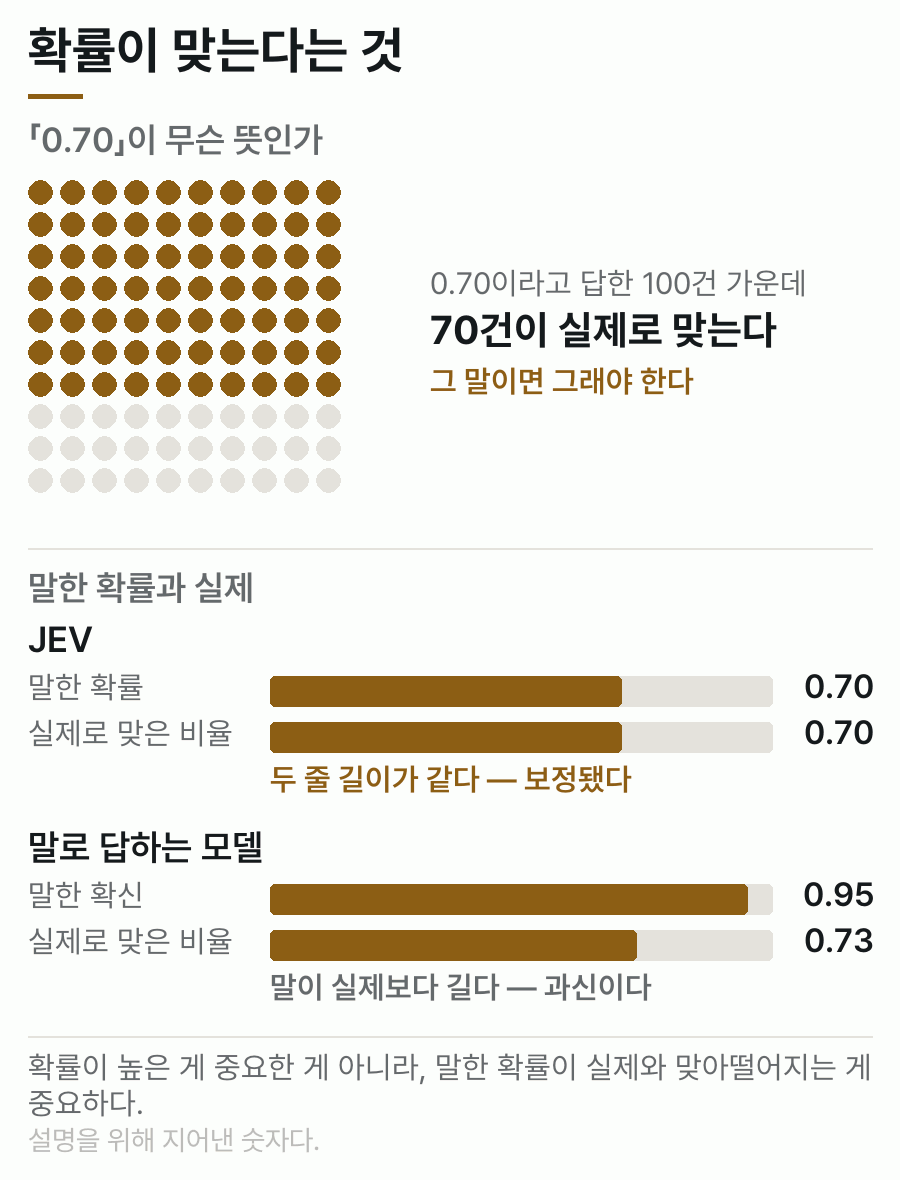
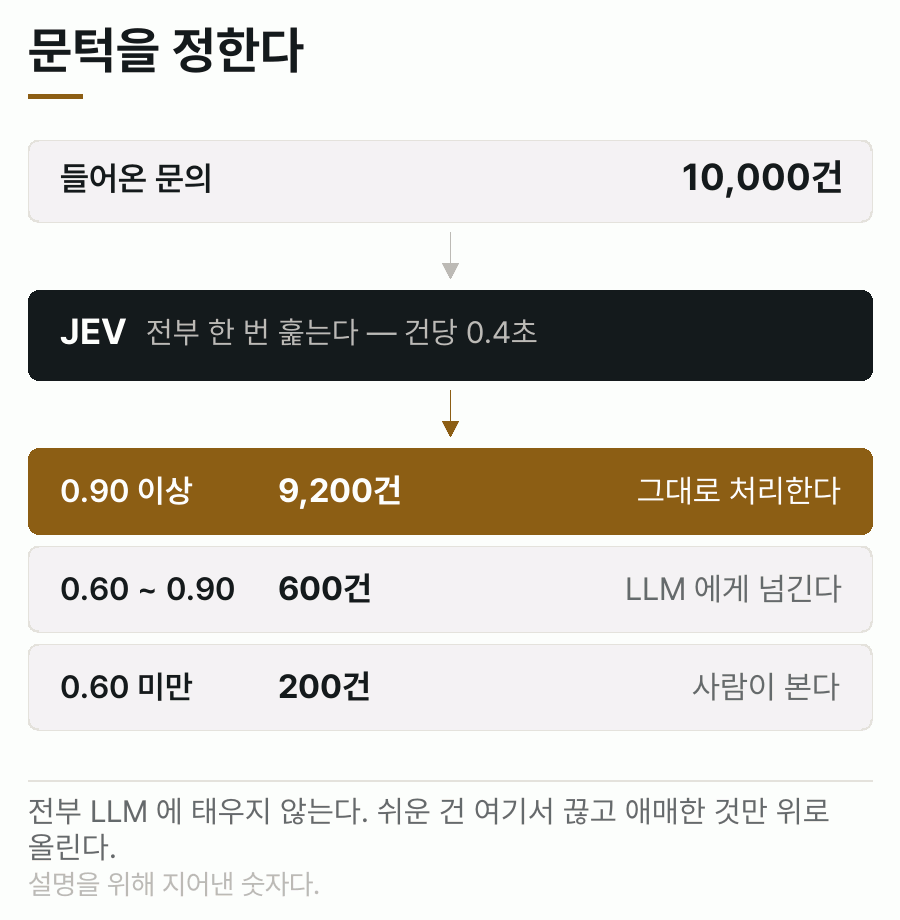
확률이 맞아떨어지면 쓰는 쪽이 편해진다. 0.9 넘으면 그냥 처리하고 0.6 밑이면 사람을 부르는 식으로 선을 그을 수 있다. 확률이 엉터리면 이런 선 자체를 못 긋는다.
환각이 없다는 말의 뜻
AI가 없는 사실을 그럴듯하게 지어내는 것을 환각이라고 부른다. JEV를 다룬 기사 제목마다 환각이 없다고 쓰여 있는데, 이게 오해를 부르기 딱 좋은 표현이다. 답이 항상 맞는다는 뜻이 아니다.
정확도는 회사가 공개한 표에서 67.8%다. 셋 중 하나는 틀린다.
없어진 건 다른 쪽이다. 보기를 네 개 줬으면 다섯 번째 답이 나올 수가 없고 1에서 5 사이를 물었으면 7이 나올 수가 없으니, 형식이 깨질 자리가 사라진 것이지 판단이 옳아진 게 아니다.
그래서 이 모델에서 중요한 건 정확도가 아니라 앞에서 본 확률인 것 같다. 틀릴 때 낮은 확률을 주기만 하면, 틀린 건 걸러 낼 수 있다.
LLM과 뭐가 다른가
회사가 공개한 비교표를 옮기면 이렇다. 상대는 당시 상위권 LLM들이다.
| JEV | 견준 LLM | |
|---|---|---|
| 정확도 | 67.8% | 67.9% ~ 74.1% |
| 건당 비용 | $0.0004 | $0.03 ~ $0.18 |
| 응답 시간 | 0.4초 | 10초 ~ 38초 |
| 형식 오류 | 0% | 0.58% ~ 5.73% |
정확도는 비슷하거나 조금 낮은 대신 비용이 두 자릿수 배로 싸고 속도가 스무 배 넘게 빠르다. 들어가는 글은 토큰 100만 개당 $0.042다. 토큰은 글을 잘게 자른 조각을 세는 단위다. 나오는 쪽은 아예 세지도 않는데, 나와 봐야 숫자 몇 개뿐이라 셀 것이 없기 때문이다.
다만 이 표는 만든 회사가 자기 워크플로로 잰 값이다. 회사가 밖에 내건 숫자는 「20배에서 200배 빠르고 40배에서 400배 싸다」인데, 기사 제목에 붙는 200배와 400배는 그 범위의 천장이다. 보통 그렇게 나온다는 뜻이 아니다.
재는 방법에도 걸리는 데가 있다. 정답지가 따로 있는 게 아니라, 성능 좋다는 다른 AI 두 개가 내놓은 답을 정답으로 놓고 쟀다. 그 둘이 똑같이 틀린 자리라면 JEV가 나란히 틀려도 맞은 것으로 잡힌다. 정확도 67.8%라는 숫자가 무엇에 대한 67.8%인지가 흐려지는 셈이다.
바깥에서 재 본 것도 이제 하나둘 나온다. 찾아보니 Every라는 곳에서 문서에서 필요한 값만 뽑아내는 일로 돌려 봤는데 속도 25배, 비용 580배였다. 비용은 회사가 말한 천장을 넘겼고 속도는 범위 안에는 들어오지만 200배와는 거리가 멀다. 방향은 맞는데 배율은 일 나름이라는 뜻으로 읽힌다.
쉬운 건 여기서 끊는다
그래서 실제로는 LLM을 대체하는 게 아니라 앞에 세우는 쪽으로 쓰는 모양이다. 들어오는 일을 JEV가 전부 한 번 훑고, 확신이 높은 건 그대로 처리하고, 애매한 것만 LLM이나 사람에게 넘기는 식이다.
Vercel 엔지니어는 기존에 쓰던 모델보다 5배에서 18배 빠르면서 정확도도 더 좋았다고 했고, Bryo AI의 CTO는 쓰던 것보다 10배에서 20배 싸다고 했다. 공개 직후 쓰겠다는 사람이 몰려 서버가 한동안 버티지 못했다.
요즘은 AI가 사람 대신 여러 단계를 알아서 처리하기도 하는데, 이런 걸 에이전트라고 부른다. 그 에이전트가 중간에 엉뚱한 짓을 하는지 단계마다 지켜보는 용도로도 쓴다고 한다. 지켜보는 쪽도 싸야 계속 지켜볼 수 있는데, 그 자리에 딱 맞는다.
JEV가 못 하는 것
목록이 짧고 분명하다.
글을 못 쓴다. 코드도 못 짠다. 왜 그렇게 판단했는지 이유를 말로 못 한다. 답의 후보를 미리 정할 수 없는 일에는 아예 못 쓴다. “이 계약서에서 문제될 조항을 찾아 줘” 같은 건 보기를 미리 못 적으니 이 모델의 일이 아니다.
근거를 글로 못 남긴다는 점은 생각보다 크게 걸린다. 금융이나 의료처럼 판단 근거를 남겨야 하는 곳에서는 숫자만 있는 기록이 감사에서 문제가 될 것 같다.
확률을 어떻게 해석할지도 결국 쓰는 사람 몫이다. Earendil의 CTO Armin Ronacher는 이걸 두고 환각 문제를 사용자 쪽에 조금 떠넘기는 셈이라고 했다. 0.5가 나왔으면 버리고 0.95면 자동으로 처리할 근거가 되는데, 그 선을 어디에 그을지는 모델이 안 알려 준다.
내 일에 적용해 볼 수 있는 것
읽다가 자꾸 되돌아간 건 세 번째 도식이었다. 고르기, 매기기, 참·거짓. 내가 요즘 LLM한테 문장으로 물어보는 것들이 대충 저 셋 안에 들어간다.
제일 먼저 걸린 건 뉴스 쪽이다. 몽골 소식을 한국어로 옮기는 사이트를 하나 굴리는데, 번역은 이미 AI가 한다. 그런데 정작 시간을 잡아먹는 건 번역이 아니라 그 앞이다. 올라온 현지 기사 목록을 놓고 이건 가져오고 저건 버리고를 정하는 일. 기준이 말로 잘 안 떨어져서 매번 내가 본다.
여기다 「이 기사는 우리 독자가 읽을 만하다」 하나만 물어서 숫자로 받으면 어떨까 싶다. 0.8 넘는 것만 번역에 태우고 나머지는 쌓아 두는 식으로. 틀려도 크게 아프지 않은 자리다. 버린 기사는 다시 보면 되고, 건당 0.0004달러면 하루 치를 통째로 돌려도 커피값이 안 된다.
지금 만들고 있는 여행 플랫폼에는 CS 채팅을 붙일 생각이다. 문의가 들어오면 예약 문제인지 환불인지 그냥 물어보는 건지 가르고, 급한 건 먼저 올리고, 애매한 것만 사람이 본다. 앞에 그려 둔 문턱 도식이 그대로 이 얘기다. 처음에는 이걸 통째로 LLM에 맡길 셈이었는데, 가르는 일과 답을 쓰는 일을 떼어 놓으면 앞쪽은 훨씬 싸게 끝난다.
당장은 못 해 본다. 제한 사전 공개라 아직 아무나 못 쓴다. 열리면 기사 고르는 자리부터 붙여 보고, 말한 확률이 실제와 맞는지부터 볼 생각이다.


댓글 남기기